No se trata de benchmarks
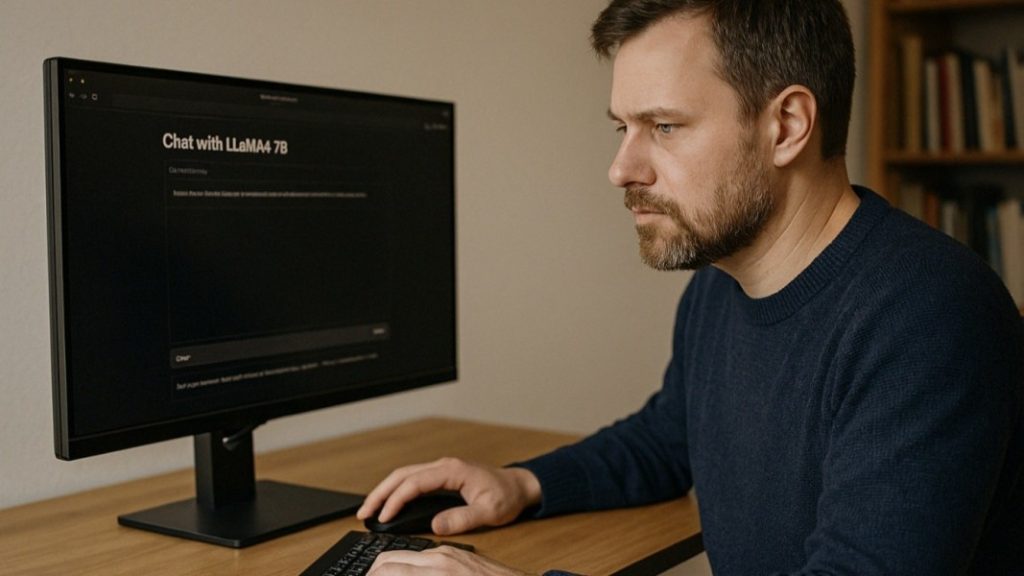
Cuando empecé a probar distintos modelos de lenguaje, no buscaba cifras de benchmark ni benchmarks teóricos. Quería saber cómo se siente realmente usarlos. Cómo es ejecutar un modelo en local, con qué rapidez responde y si ofrece resultados consistentes y útiles sin derivar en alucinaciones.
Este artículo se centra en el uso en el mundo real. Lo que me funcionó. Lo que falló. Dónde están los límites. Y cómo se comportó cada modelo cuando se le asignaron tareas como resumir texto, comparar ejemplos o responder a preguntas por capas. Esto no es una clasificación. Es una perspectiva personal y práctica basada en el uso repetido.
Modelos que se quedaron en mi conjunto de herramientas
Después de mucho ir y venir, he acabado usando Ollama, OpenGPT y DeepSeek con regularidad. Estos modelos me han dado la experiencia más estable en mis pruebas del día a día. Suelen mantener el hilo de la conversación mejor que otros y conservar la relevancia en sus respuestas durante más tiempo.
No son perfectos, pero manejan de forma consistente tareas básicas y de nivel medio sin necesitar reinicios o correcciones constantes. Eso por sí solo los hace valiosos.
Una mirada más de cerca a BOLT
BOLT merece su propia sección. Lo uso sobre todo a través de LM Studio porque, en mi experiencia, no se ha integrado sin problemas con OpenWebUI. Pero una vez que está en marcha, es rápido. De los más rápidos en responder.
BOLT ha ido bien en tareas que implican salida estructurada. Cosas como dar formato a registros, estructuras JSON simples o muestras YAML han funcionado sorprendentemente bien. El rendimiento es fiable cuando ejecutas prompts enfocados.
Dicho esto, las versiones más pequeñas de BOLT sí sufren los mismos problemas que otros modelos compactos. Alucinan y pierden contexto cuando los prompts se vuelven más complejos o cuando la conversación se alarga.
El punto de ruptura de los modelos pequeños
Cada vez que he probado modelos de menos de 7 mil millones de parámetros, el resultado ha sido el mismo: arranque rápido pero capacidad muy limitada. Estos modelos pequeños olvidan el contexto rápidamente, responden con texto vago o genérico y se desvían con facilidad. Son útiles si solo quieres experimentar o ver si una configuración funciona, pero no deberían usarse para nada crítico.
Si la tarea requiere profundidad o memoria, cualquier cosa por debajo de 7B no es una opción real. Y aun en 7B, todavía hay concesiones. He tenido mejor consistencia al usar modelos de 13B, especialmente al hacer preguntas de varios pasos o por capas.
Cómo pruebo en la práctica
Mis pruebas no tratan de prompts sintéticos. Uso modelos en tareas reales: resumir documentos, analizar notas, probar mensajes de error y, de vez en cuando, redactar respuestas o comparaciones.
También uso la repetición. Le doy la misma tarea a varios modelos y comparo las salidas. Este enfoque me da una visión más clara de dónde un modelo se queda corto o me sorprende. Con el tiempo, se vuelve evidente en cuáles puedes confiar y cuáles solo se ven bien sobre el papel.
El tamaño importa, pero no siempre como crees
He trabajado tanto con modelos de 7B como de 13B y, aunque los modelos de 13B son más capaces y consistentes, también exigen más de tu sistema. Necesitas suficiente memoria libre para cargarlos y ejecutarlos correctamente, o se bloquearán o irán lentos.
Si tu hardware es limitado, los modelos de 7B pueden hacerse funcionar. Pero tienes que mantenerte dentro de sus límites. Para resúmenes rápidos o respuestas puntuales, van bien. Pero en cuanto les pides que piensen a través de múltiples pasos, a menudo se rompen.
Mi conclusión después de todas estas pruebas
Probar modelos locales no consiste en encontrar el modelo más inteligente. Consiste en encontrar lo que funciona para tu caso de uso y tu sistema. Me importa menos lo ingenioso que suene un modelo y más si puede terminar una tarea sin necesitar un reinicio.
La IA local te da las herramientas para elegir. Puedes probar, borrar, cambiar y ajustar cosas de una manera que los servicios en la nube no permiten. Ese es el poder. Pero también significa que necesitas ser realista.
Empieza con algo simple. Ten paciencia. Y deja que tus propios casos de uso te guíen. Así es como más he aprendido.
No se trata de sustituir la IA en la nube. Se trata de construir algo que sea tuyo, que funcione bajo tus condiciones y que se adapte a tus necesidades diarias sin concesiones.
Markku Arvekari
Experto en Transformación Digital